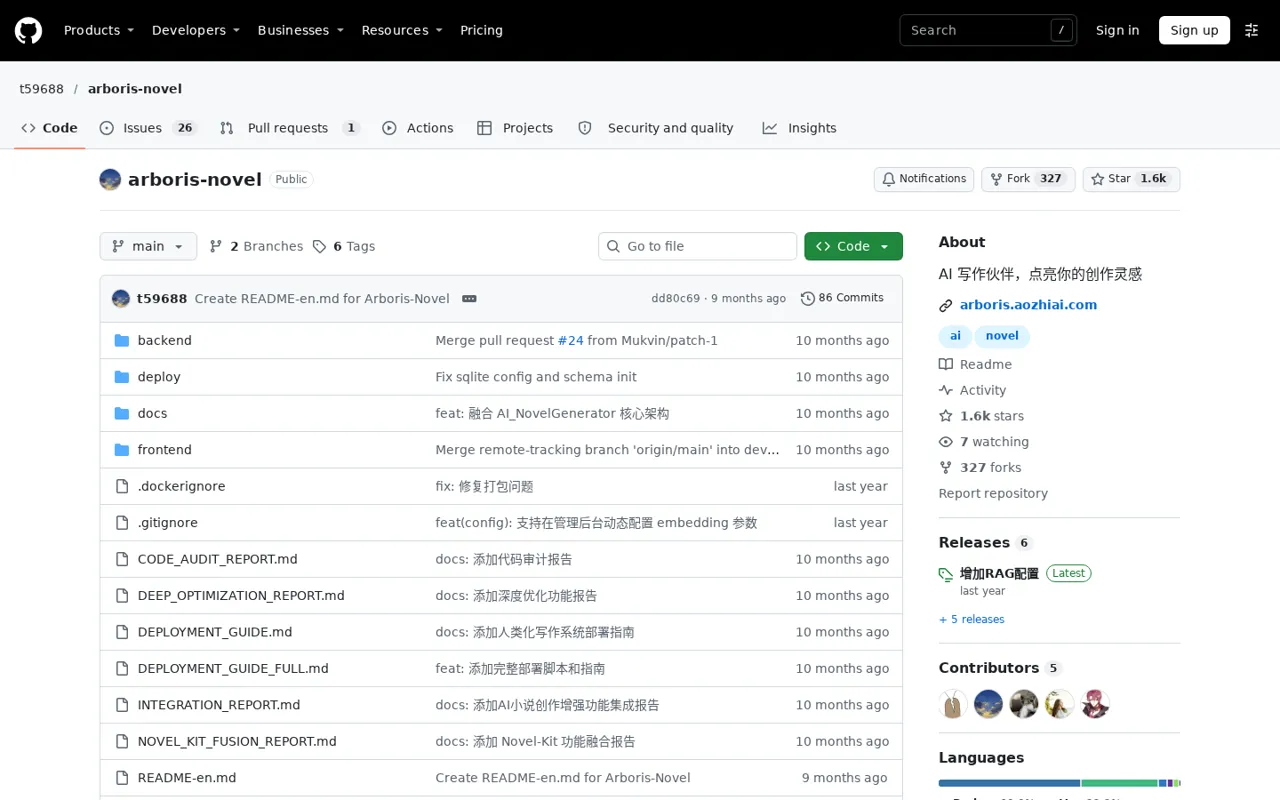
Arboris-Novel:AI写小说利器 - v1.1.3版
Arboris-Novel 是开源的 AI 辅助小说写作工具(GitHub t59688/arboris-novel),主打设定管理、大纲梳理与多版本对比,Docker 自部署、自备模型 API Key。

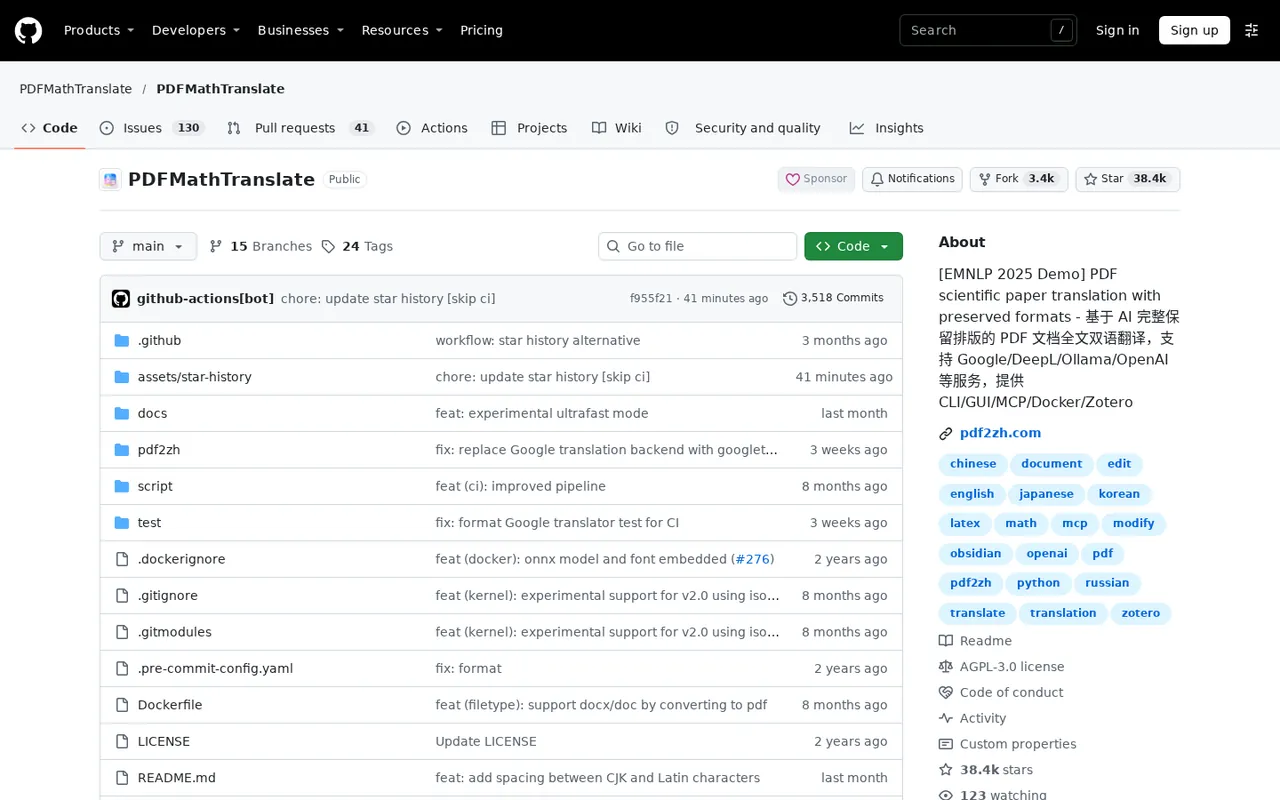
PDFMathTranslate 的 GitHub 仓库首页,2026-11 截图
PDFMathTranslate(命令行包名 pdf2zh)是一个专为科研论文设计的 PDF 文档翻译工具,核心卖点是在翻译全文的同时保住版式:公式、图表、目录与注释的位置和样式尽量原样保留,而不是把 PDF 粗暴转成纯文本再翻译。它由开发者 Byaidu 发起,现仓库位于 GitHub 的 PDFMathTranslate 组织下。截至 2026 年 11 月快照,仓库星标约 3.8 万。项目以 Python 编写,采用 AGPL-3.0 协议开源,通过 PyPI 分发(包名 pdf2zh),同时提供 Docker 镜像。形态上有三种用法:命令行工具、交互式图形界面(Gradio 界面)、Docker 部署;官方还在 HuggingFace Spaces 与 ModelScope 上挂有在线 Demo 可直接体验。仓库与文档提供简体中文版 README,对中文用户相对友好。
PDFMathTranslate 切中的是一个长期痛点:科研人员读英文论文时,通用翻译工具要么只能翻网页和纯文本,要么把 PDF 拆得面目全非——公式错位、图表分离、参考文献顺序全乱。它的技术路线是先用文档版面分析把 PDF 拆成文本块、公式与图表区域,只翻译文本部分,再按原坐标回填排版,从而实现「译文长得像原文」。项目在 GitHub 公开后迅速积累人气,成为中文科研圈讨论度最高的论文翻译工具之一,并被 Zotero 生态等周边项目集成或引用。需要注意它的版本脉络:原仓库(1.x)仍在维护,README 已明确公告 2.0 正式版迁移到组织下的新仓库 PDFMathTranslate-next 发布;2026 年的更新日志显示 1.x 线仍在加入实验性 OCR、–ultrafast 快速模式等能力。换句话说,现在入门要先分清自己装的是哪一代,两代的安装与参数并不完全相同,本文口径以原仓库 README(2026-11 核查)为准。
PDFMathTranslate 高级选项文档(ADVANCED.md),2026-11 核查
第一是版式保留翻译:公式、图表、目录、注释在译文中保留原位,输出两个文件——单语译文 PDF(-mono)与中英双语对照 PDF(-dual),对照版尤其适合精读时逐段核对。第二是翻译服务可插拔:默认使用 Google 翻译,也可切换 DeepL、Ollama 本地模型、OpenAI 兼容接口等多种服务(完整清单见官方 ADVANCED 文档),免费通道与自带 API Key 的高质量通道可以按需替换。第三是灵活的翻译范围:支持整篇、指定页范围的部分翻译、直接给在线 PDF 链接翻译,源语言与目标语言可指定,覆盖科研常见语种组合。第四是持续增强的文档理解:2026 年的更新加入了实验性 OCR 支持(应对扫描型 PDF)、–ultrafast 模式(对原生文本 PDF 跳过版面分析与 OCR 以换取速度)、段落重组与自适应排版等改进。第五是部署形态齐全:本地 CLI 批量处理、GUI 图形界面点选操作、Docker 一条命令起服务,还能通过在线 Demo 零安装试翻几页。
最常见的入门路径是 pip 安装:pip install pdf2zh 后,命令行执行 pdf2zh 论文.pdf 即以默认的 Google 服务生成译文与双语两个 PDF;加 -i 参数进入图形界面,适合不熟悉命令行的用户拖放文件操作。进阶参数都在 ADVANCED 文档里:用 -p 指定页、-li/-lo 指定源/目标语言、–service 切换翻译服务,用 DeepL 或大模型服务时按文档配置对应的 API Key。没有本地环境的用户,可以先打开官方在 HuggingFace Spaces 或 ModelScope 上的 Demo 翻一两页验证效果,或使用 Docker 镜像在服务器上部署。处理长篇论文时建议先翻几页抽查公式与图表区域的质量,再整篇跑,避免浪费翻译额度。
核心人群是需要大量阅读英文文献的研究生、科研人员与工程师:整篇翻译加双语对照的形态,正是为「快速把握论文内容、精读时对照原文」设计的。留学生与备考者读英文教材、技术文档同理受益。其次是企业技术团队评估外文专利、白皮书与手册,需要保留图表版式以便内部传阅。不太适合的场景包括:对排版有出版级要求的正式文件(它的目标是可读,不是原样复刻印刷品质);高度机密的未发表成果——若使用在线翻译服务,文本会经过第三方服务器,这类文档应选择本地模型(Ollama)通道或完全离线方案;以及只需要翻一句话、一个网页的轻量需求,那用浏览器翻译插件明显更快。
pdf2zh 在 PyPI 的包页面,2026-11 核查
软件本身免费:AGPL-3.0 开源,PyPI 与 Docker 镜像均可免费获取,在线 Demo 免费试用(受托管平台额度限制)。真正的成本在翻译服务这一层:默认的 Google 通道可免费使用,但稳定性与限额不受控;DeepL、OpenAI 兼容的大模型接口等服务需要自备 API Key 并按各服务商的价格付费,费用取决于篇幅与调用量,与 PDFMathTranslate 本身无关。粗略的经验口径是:一篇十几页的论文,用免费通道零成本,用付费大模型通道通常也是小额支出,但批量翻译整个文献库前务必先小样测算。AGPL 协议另有一个对开发者重要的含义:若你把它改造后作为网络服务对外提供,需要按协议开源你的修改,这一点商用集成前要先评估。
优点:第一,版式保留是真功夫,公式图表不乱位、双语对照输出,对论文阅读场景的贴合度远高于通用翻译工具;第二,翻译服务可替换,从免费的 Google 到 DeepL、本地 Ollama 与各类大模型接口,质量与成本自己权衡;第三,上手路径多,CLI、GUI、Docker、在线 Demo 一应俱全,中文文档齐备;第四,社区活跃且迭代快,OCR、快速模式等能力在 2026 年仍持续加入。缺点:第一,效果上限取决于 PDF 本身与翻译服务,扫描质量差、版式极复杂的文档仍可能出现错位或漏译,需要人工抽查;第二,两代版本(1.x 与 2.0 新仓库)并行容易让新手装错、查错文档;第三,免费翻译通道稳定性一般,长文档中途失败需要重试或分段;第四,本地部署对 Python 环境有一定要求,纯小白用户更适合先从在线 Demo 或 GUI 用起。
同为「把外文变成中文」这件事,站内几款工具的路线截然不同:
| 工具 | 定位 | 费用模式 | 运行平台 | 中文支持 |
|---|---|---|---|---|
| PDFMathTranslate | 科研 PDF 全文翻译,保留公式图表版式 | 软件免费;翻译服务按所选通道计费 | Windows / macOS / Linux(CLI/GUI/Docker) | 有中文文档 |
| 沉浸式翻译 | 浏览器扩展,网页与文档双语对照翻译 | 免费版加会员订阅 | 浏览器扩展 / 移动端 | 中文产品 |
| Canva | 在线设计平台,附带文档与翻译类功能 | 免费版加 Pro 订阅 | Web / 移动端 | 有中文版 |
| 豆包 | 字节跳动 AI 助手,对话式问答与翻译 | 基础功能免费 | Web / 移动端 / 桌面端 | 中文产品 |
选型思路:整篇论文、书籍章节要成文件地翻译并保留版式,用 PDFMathTranslate;日常刷网页、看文档想要双语对照,沉浸式翻译更顺手;翻译只是设计物料的一小环,Canva 里顺带完成;临时问一句、翻一段,豆包这类 AI 助手最快。
第一,隐私:使用在线翻译服务(包括默认通道)意味着论文文本会上传到第三方服务器,未发表成果、涉密文档应改用本地 Ollama 等离线通道,或先做脱敏。第二,准确性:机器翻译对专业术语、公式上下文的误译并不罕见,引用译文数据与结论前必须回对原文,双语对照 PDF 正是为此而备。第三,版权:翻译他人著作的 PDF 供个人学习与传播、商用是两回事,后者需取得授权。第四,版本选择:安装前确认自己跟的是 1.x 原仓库还是 2.0 新仓库的文档,参数与包名细节有别。第五,额度管理:用付费 API 通道批量翻译前,先以几页样本估算单篇成本再放量。