智剪:智能视频自动剪辑与AI解说工具 - 最新版
智剪(JJYB_AI_VideoAutoCut)是个人开发者维护的 Windows 本地 AI 剪辑工具,主打原创解说、智能混剪、AI 配音与声音复刻,可导出剪映草稿,素材本地处理不上传。个人免费,禁止未授权商用。
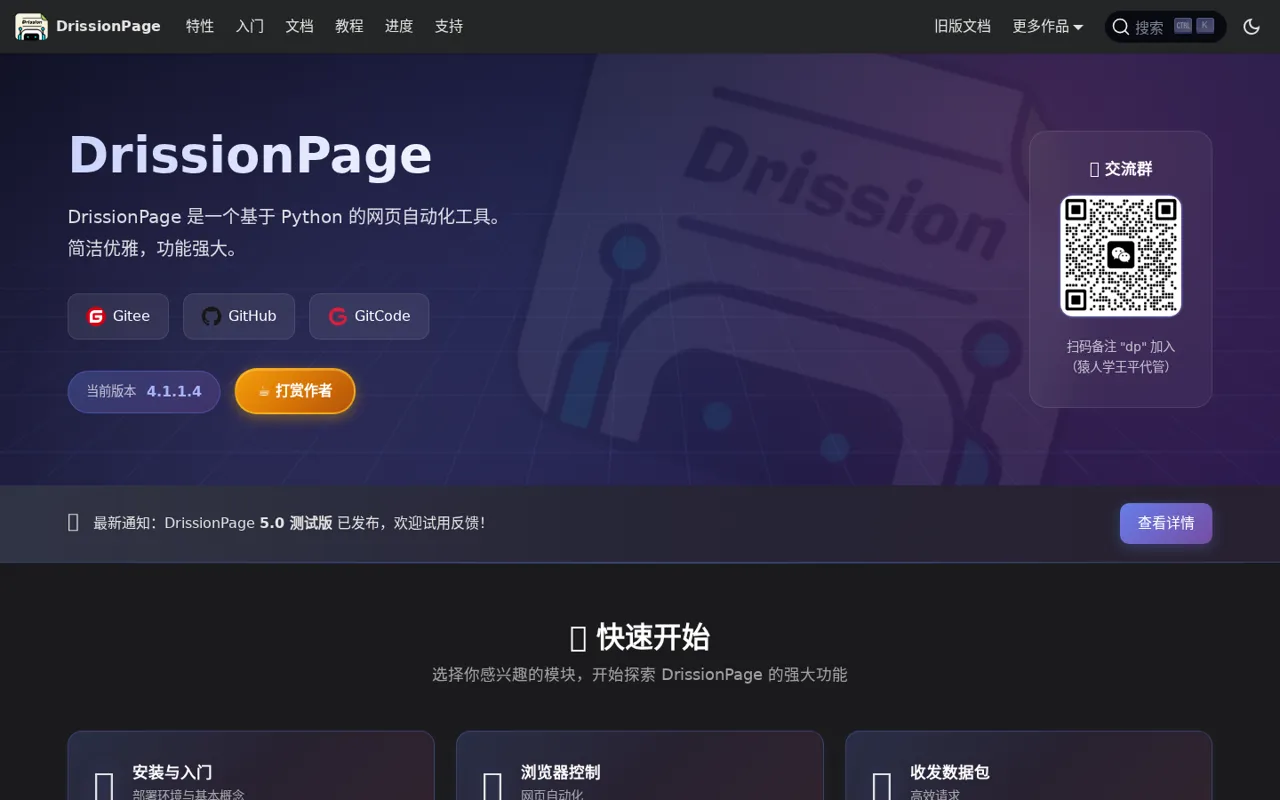
图:DrissionPage 官网首页,文档标注适用于 4.1.1.4 版,并预告 5.0 测试版(2026-11 截图)
DrissionPage 是一个基于 Python 的网页自动化工具库,用 pip 安装后即可在脚本中调用。它最大的特点是把两种主流网页操作方式合而为一:既能像 Selenium 那样驱动 Chromium 浏览器完成点击、填表、截图,也能像 requests 那样直接收发数据包取数,两种模式还可以在同一次任务中切换并共享登录状态。
基本信息:作者为开发者 g1879,个人开发维护;官网 drissionpage.cn 是中文文档站,源码托管在 GitHub 仓库 g1879/DrissionPage,另有 Gitee、GitCode 镜像。项目 2020 年 5 月在 GitHub 建仓;截至 2026 年 11 月快照,官网标注当前版本为 4.1.1.4,GitHub 仓库约 1.26 万 Star、2026 年 10 月仍有代码推送,官网已发布 5.0 测试版供试用。运行环境为本机 Python 加 Chromium 内核浏览器,不需要单独的服务器。
DrissionPage 的出现,针对的是 Python 自动化领域长期存在的割裂:Selenium 一类工具控制浏览器,需要额外下载与浏览器版本匹配的 webdriver,语法也偏繁琐;requests 一类工具收发数据包速度快,却处理不了 JavaScript 渲染和登录交互。作者自研了一套基于 CDP 协议直连浏览器的内核,免去驱动配置,再把数据包模式收进同一个库里,形成现在的产品形态。
项目主要在中文爬虫与自动化社区传播,配套有 B 站视频教程、交流群、知识星球与离线文档等学习资源,官网「更多作品」还列有 DrissionRecord(操作录制)、DrissionGet、TimePinner 等同作者周边工具。仓库附有 LICENSE 文件,但 GitHub 未能将其自动识别为常见标准协议,社区与本站一直按「个人学习、非盈利使用」的口径介绍它,商业使用前应先通读许可证原文。
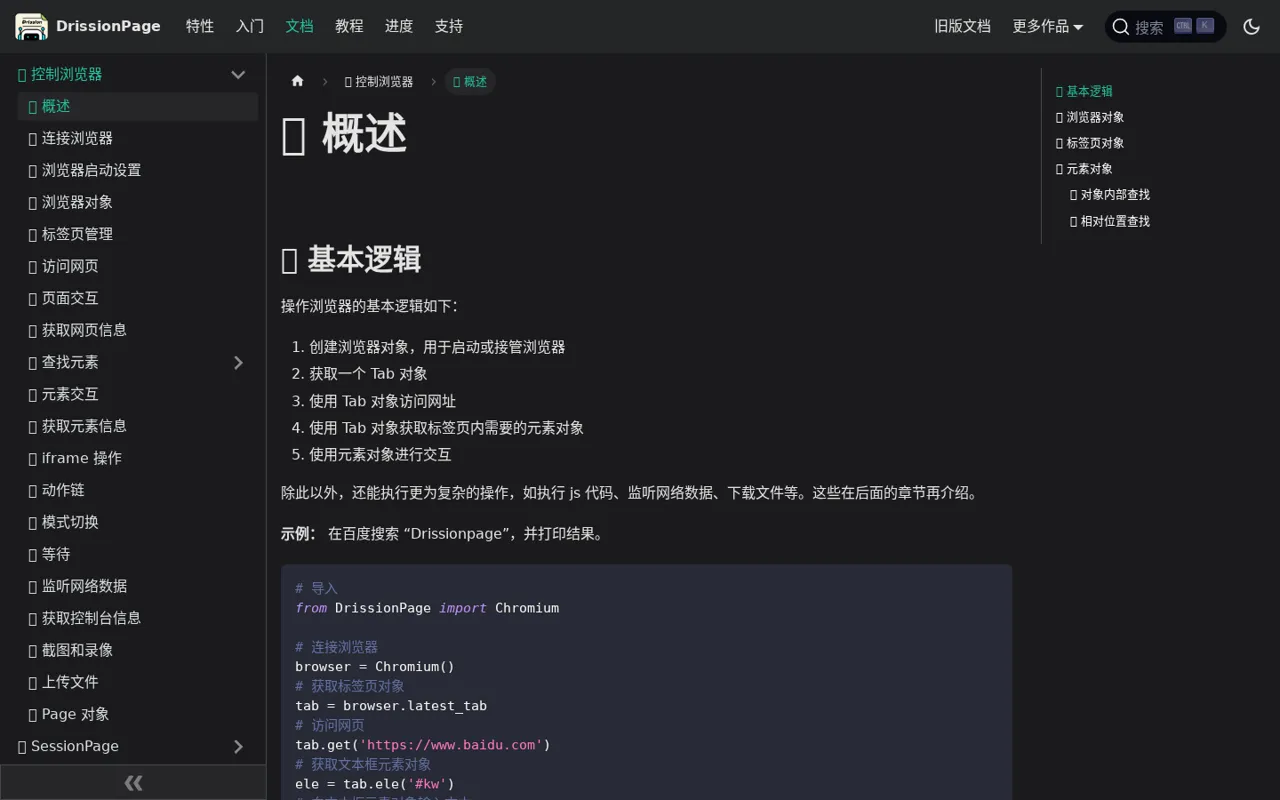
图:DrissionPage 官网「浏览器控制」文档页,介绍控制 Chromium 的基本用法(2026-11 截图)
用一个典型任务可以看出它与 Selenium 的差别:同样是「登录后翻页抓取列表」,Selenium 需要先配驱动、再处理 iframe 切换与显式等待,DrissionPage 则可以直接跨 iframe 定位元素点击,翻页时还能顺手监听数据包,把列表背后的接口请求截下来改用数据包模式直连——浏览器只负责过登录与渲染,真正取数走接口,速度和稳定性都更好。这正是它在采集场景里被高频推荐的原因。
先用 pip install DrissionPage 安装,再在脚本中引入 ChromiumPage,传入网址即可打开页面,用其定位语法找到元素后执行点击、输入、读取文本等操作;如果目标数据有现成接口,也可以改用 SessionPage 以类似 requests 的写法直接请求,把速度提上去。官网文档的学习路径是「入门 → 安装与入门 → 浏览器控制 / 收发数据包」,每节配可运行示例,遇到问题可查文档站内搜索或到交流社区提问。
还有两个容易被忽略的点:其一,它对 Chromium 的接管方式让已打开的浏览器、已登录的会话可以直接复用,调试时不必在「人工浏览器」和「脚本浏览器」之间反复切换;其二,遇到问题时先查文档站的版本说明页(如 4.1.x 变更记录),很多「昨天还能跑、今天报错」的故障其实源于小版本写法调整,而不是目标站点改版。
学习支持方面,官网首页设有专门的「学习资源」区:交流社区汇总实战案例与问题解决帖,作者在 B 站有视频教程账号,还提供离线文档与实用程序下载,联系方式(邮箱、微信)直接公开在官网。对中文用户来说,这套「文档加视频加社群」的组合,比只有英文文档的国外框架更容易跨过最初的学习门槛。
适合有 Python 基础、需要批量采集网页数据的数据采集与爬虫工程师;需要做 Web 自动化测试的测试工程师;以及想找一个中文文档友好、上手快的新手友好的自动化库的学习者。如果任务只是偶尔下载单个文件或操作完全无 JS 的静态页面,它的能力会显得过剩。
从生态位置看,它和 Selenium、Playwright 的分工也值得说清:Selenium 胜在跨浏览器与多语言绑定,Playwright 胜在现代化的测试体系与多浏览器引擎,两者都是大型组织维护的通用框架;DrissionPage 的差异化在于「浏览器加数据包」的双模式和中文文档社区,更偏向数据采集这一垂直场景。如果你的主业是采集而不是测试,它通常是更顺手的选择;反之,大型跨浏览器测试项目仍应优先考虑前两者。
DrissionPage 本身免费开源,没有官方付费版本或会员档位(2026-11 快照)。实际使用成本主要来自运行环境:本机浏览器与算力、可能需要的代理 IP 等第三方服务,官网页面上也挂有代理服务商的广告,选用与否与库本身无关。此外作者接受打赏,知识星球等付费内容属于社区学习资源,需要与工具本身的授权分开看;具体安排以官网为准。
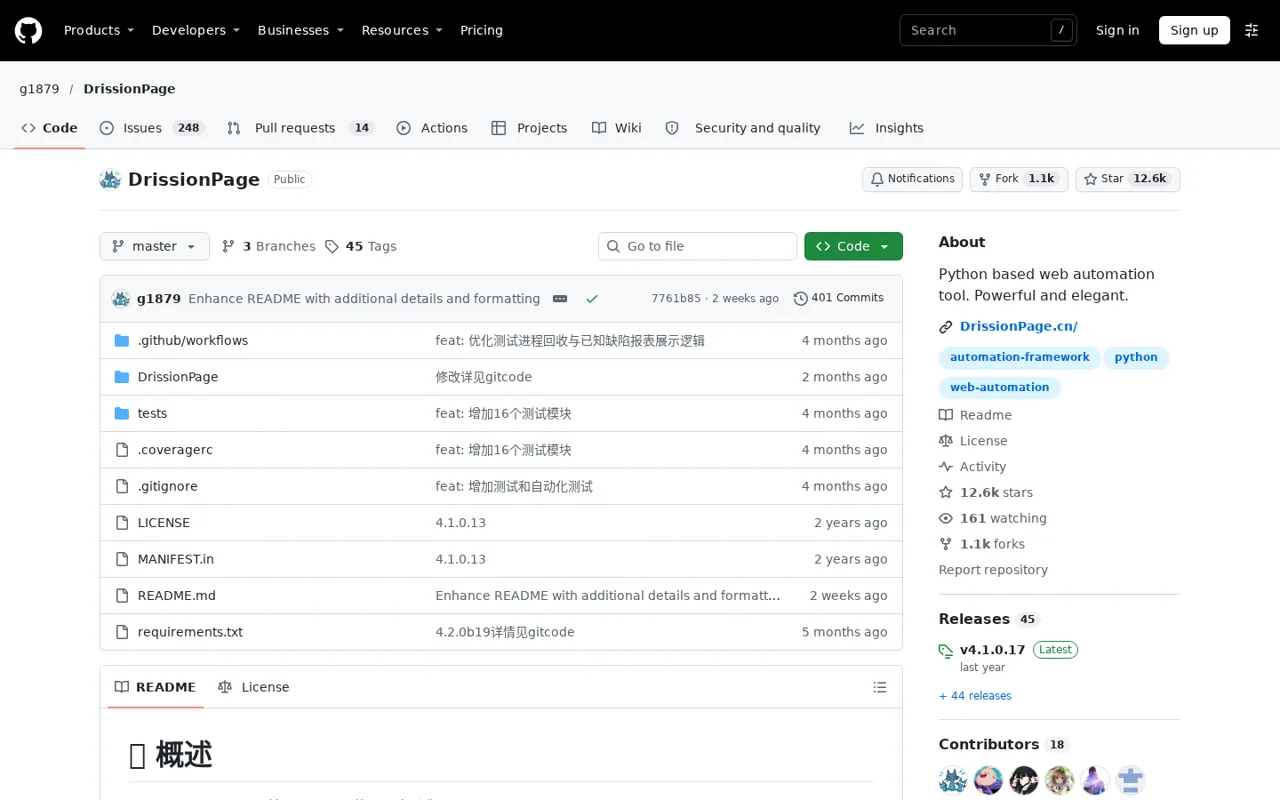
图:DrissionPage 的 GitHub 仓库页,含版本发布与源代码(2026-11 截图)
优点:
缺点:
| 维度 | DrissionPage | screenpipe | yt-dlp |
|---|---|---|---|
| 定位 | Python 网页自动化库 | AI 屏幕与音频记录工具 | 命令行音视频下载器 |
| 作用对象 | 网页 DOM 与网络请求 | 整个桌面屏幕与声音 | 视频站点链接 |
| 使用形态 | 写 Python 代码调用 | 常驻运行后检索回放 | 命令行输入链接下载 |
| 典型场景 | 数据采集、自动化测试、批量操作 | 记录与检索自己操作过的内容 | 下载公开音视频存档 |
| 上手门槛 | 需要 Python 基础 | 安装配置偏重 | 需要命令行基础 |
站内可进一步看 screenpipe 与 yt-dlp 的深度评测:三者都常被归到「自动化/数据获取」工具里,但 DrissionPage 面向的是网页本身的操作与采集,和记录屏幕、下载视频并不是同一类需求,选型时先分清任务对象。