Gemini英语口语助手 - 0.1.1版
Gemini 英语口语助手是开源的 AI 口语陪练工具,基于 Gemini Live API 实时识别发音、纠正语法并进行情景对话,需 Python 3.11 环境与自备 Gemini API Key 才能运行。
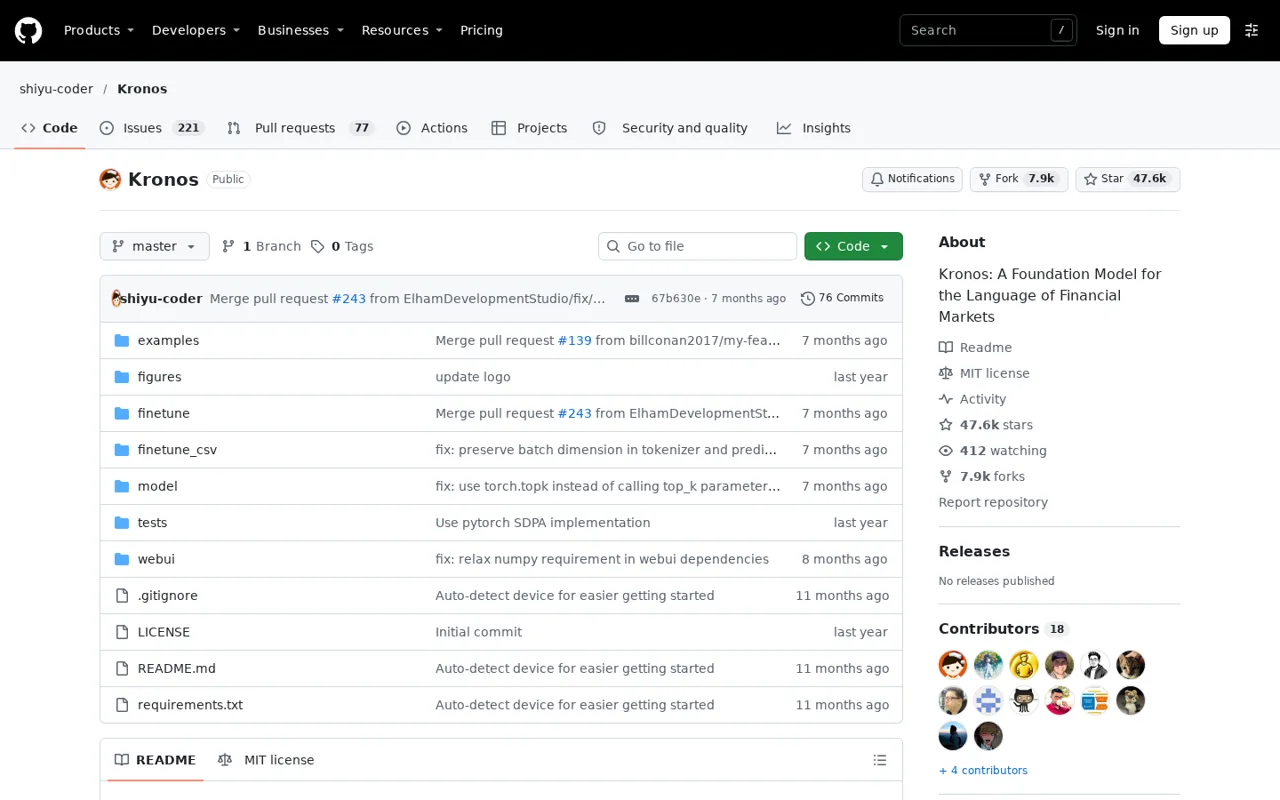
Kronos 是清华团队开源的金融 K 线基础模型:把 OHLCV 序列当语言预训练,覆盖 45+ 交易所,论文被 AAAI 2026 录用,mini/small/base 权重免费开放,适合量化研究二次开发。
15 人已下载 手机查看
图:Kronos 的 GitHub 仓库首页,自我定位为首个开源金融 K 线基础模型(2026-11 截图)
Kronos 是一个专为金融 K 线数据训练的开源基础模型,代码仓库为 GitHub 上的 shiyu-coder/Kronos,MIT 许可证,主体语言 Python。它和通用大语言模型的区别在于「读」的对象不同:不读文字,读开盘、最高、最低、收盘和成交量组成的 K 线序列,把市场行情当成一门语言来建模。仓库创建于 2025 年 7 月,截至 2026-11 快照已有约 4.76 万 Star、7,874 个 Fork,是这一年金融 AI 开源项目里热度最高的一个。
配套资源都在明处:论文在 arXiv(编号 2508.02739,2025 年 8 月发布),权重托管在 Hugging Face 的 NeoQuasar 名下,在线演示站 shiyu-coder.github.io/Kronos-demo 展示它对 BTC/USDT 未来 24 小时的预测曲线。站内旧稿写它当时只有 77 个 Star,那是收录初期的数字,早已过时。
仓库主页同时挂着提交活跃度与 Star 趋势徽章,热度不是一波流:2025 年 7 月开源后,它的 Star 增长持续了数月,在金融类开源项目中属于少见的长尾。
Kronos 出自清华系的研究团队,站内旧稿列出的论文作者包括 Yu Shi、Zongliang Fu、Shuo Chen 等人,通讯作者为 Changshui Zhang 与 Jian Li(以论文与仓库信息为准)。这个项目的学术路径走得很完整:2025 年 7 月开源,8 月放出论文和微调脚本,2025 年 11 月 10 日仓库公告已被 AAAI 2026 录用——对一个开源模型来说,顶会录用意味着它的方法经过了同行评审,不是只有代码没有论证。
它要解决的问题是:金融时间序列长期没有一个像样的「预训练底座」。过去做价格预测、波动率预测,每个任务都要从零训一个小模型,数据和算力都浪费。Kronos 的思路是先在一个跨 45+ 全球交易所的大规模 K 线语料上预训练出通用表征,再让下游任务直接调用或微调,这和 NLP 里预训练语言模型的做法是同一条路线。
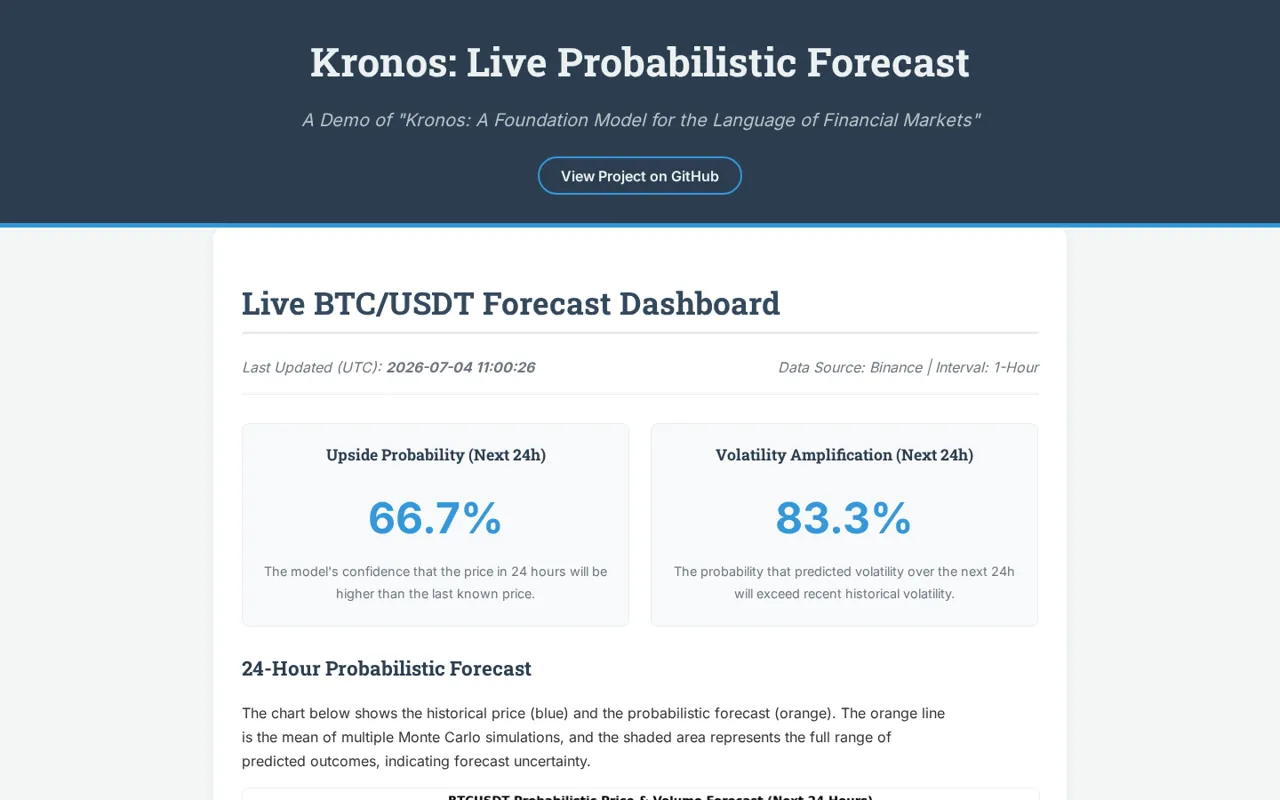
图:Kronos 官方在线演示页,展示 BTC/USDT 未来 24 小时的预测曲线(2026-11 截图)
一个常被问的问题是:它和 ChatGPT 这类模型是什么关系?答案是只有架构上的亲缘——同为解码器式 Transformer,但 Kronos 的词表里没有一个汉字或英文单词,全部是 K 线形态的离散编码;它不会聊天、不会写研报,只会顺着给定的行情往下「续写」价格路径。把它放进系统时,正确的预期是把它当一个可微调的行情特征提取器和预测头,而不是一个会思考的交易员。
环境要求 Python 3.10 以上。标准路径是:克隆仓库后 pip install -r requirements.txt 装依赖,从 Hugging Face 加载分词器与模型权重(例如 NeoQuasar/Kronos-small 配 NeoQuasar/Kronos-Tokenizer-base),用官方 KronosPredictor 类喂入一段历史 K 线(DataFrame 格式),即可输出未来若干根 K 线的预测,类内部处理归一化与反归一化。注意 small 与 base 的最大上下文是 512 根 K 线,输入更长会被自动截断,喂数前先确认自己的周期和回看长度。只是做推理的话消费级 GPU 就能跑 mini 和 small;真要微调,建议按仓库示例准备 Qlib 格式的数据和一块像样的显卡。
关于复现成本,再交代一句:官方示例以 BTC 等加密货币和主流股指的公开数据为主,数据获取本身不难;真正花时间的是把自家数据对齐到它的分词口径(周期、复权、缺失值处理),这一步做错,后面所有结果都不可信。
Kronos 本体完全免费开源:代码 MIT 许可证,mini、small、base 三个规格的权重在 Hugging Face 免费下载,演示站免费访问,没有官方付费版或订阅(2026-11 快照)。真正的成本在使用者一侧:跑推理和微调的算力、行情数据的获取与清洗、以及把预测接进真实交易系统前的回测与验证工作。large 版本未开源,官方也未公布其获取方式(未公开/以仓库为准)。
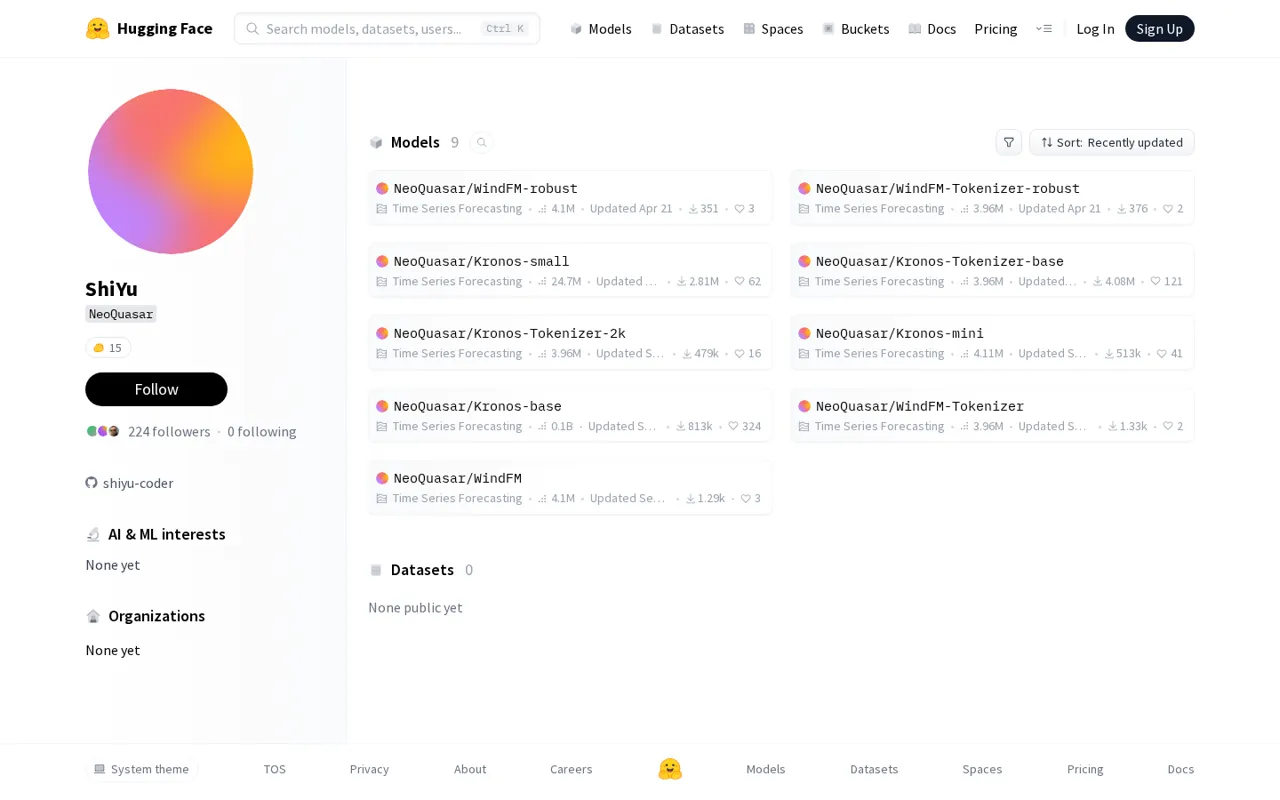
图:Kronos 权重托管在 Hugging Face 的 NeoQuasar 名下,含分词器与三个已开源规格(2026-11 截图)
优点:
缺点:
| 项目 | 形态 | 定位 | 开源与收费 |
|---|---|---|---|
| Kronos | 预训练模型+代码 | K 线序列的基础模型,供二次开发 | MIT 开源,小/中权重免费 |
| OpenBB | 数据平台 | 金融数据聚合与研究工作台,解决「数据从哪来」 | 开源平台+商业服务 |
| TradingAgents | 多智能体框架 | 用多个 LLM 智能体模拟分析师团队做研判 | 开源 |
三者不在同一层:OpenBB 管数据,Kronos 管模型,TradingAgents 管决策流程。实际做量化系统时常见的组合恰恰是把它们串起来——OpenBB 供数、Kronos 出预测、智能体框架做综合判断。