
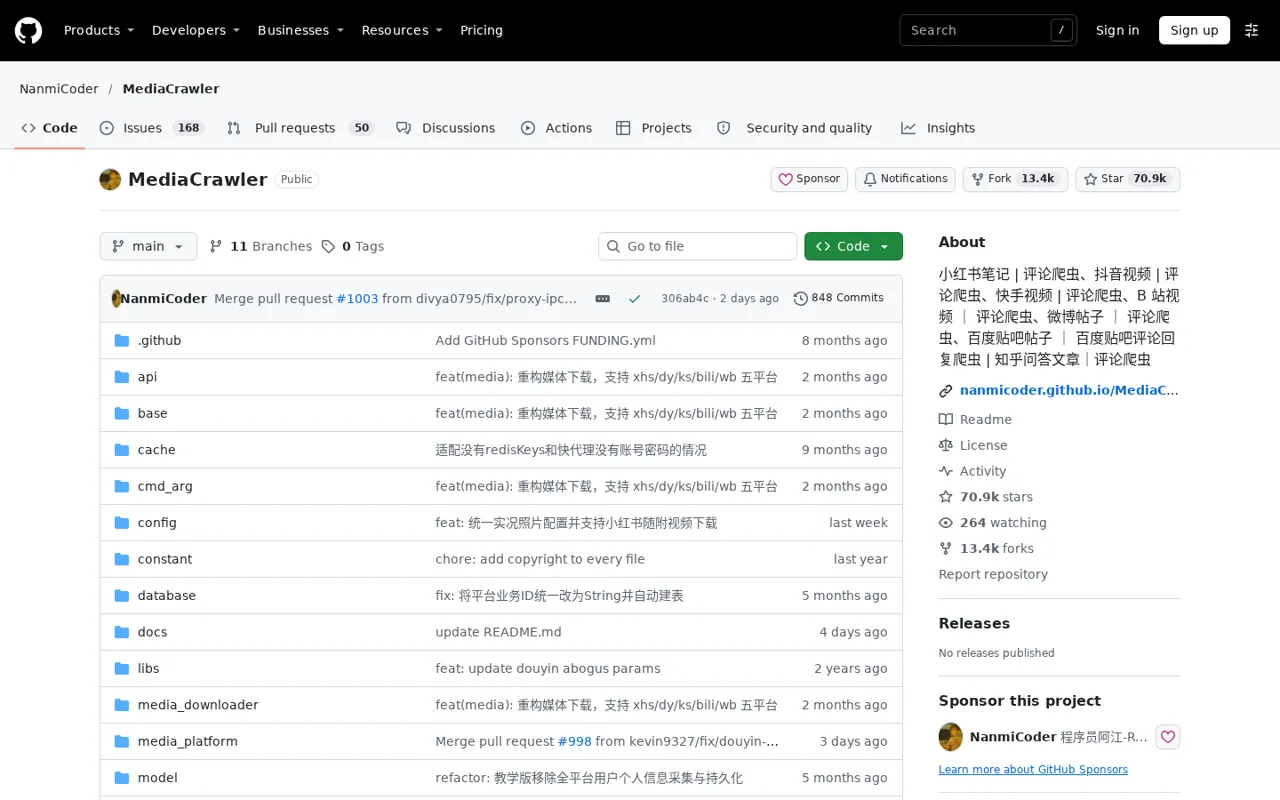
图:MediaCrawler 的 GitHub 仓库主页,支持小红书、抖音、快手、B 站、微博、贴吧、知乎七个平台的公开数据采集(2026-11 截图)
定位与基本信息
MediaCrawler 是一个开源的多平台自媒体数据采集工具,用 Python 写成。它做的事情是:用你自己的账号登录小红书、抖音、快手、B 站、微博、百度贴吧、知乎这七个平台,按关键词搜索、按指定帖子、按创作者主页三种方式,把帖子与评论等公开信息抓取下来,存成文件或数据库。它定位给做内容研究、舆情观察和技术学习的人,作者在仓库首页和许可证里都明确写了「仅供学习研究、禁止商业用途」,这句话不是客套,是这个项目的实际使用边界(详见注意事项)。
- 软件形态:开源命令行工具,附带可本地运行的 WebUI
- 仓库:github.com/NanmiCoder/MediaCrawler,2023 年 6 月建仓
- 技术栈:Python + Playwright / Chrome CDP
- 覆盖平台:小红书、抖音、快手、B 站、微博、贴吧、知乎(共 7 个)
- 许可证:非商业学习许可(NON-COMMERCIAL LEARNING LICENSE 1.1),非标准开源许可证
- 热度:约 70,861 星、13,405 次 fork(2026-11-11 GitHub 快照)
- 费用:开源版免费;另有功能更全的 MediaCrawlerPro 付费订阅版(价格未公开)
平台背景
作者是开发者 NanmiCoder(Relakkes),项目 2023 年 6 月发布,是国内社交平台采集方向星数最高的开源项目之一,并且还在高频维护:2026 年 11 月 9 日仍有代码推送,未关闭 issue 两百多条,社区规模不小。它的技术路线在同类工具里比较有代表性:不去逆向各平台的签名加密算法,而是用自动化浏览器保留登录状态,在已登录的页面环境里取签名参数,从而绕开最难啃的一段——代价是运行要带着一个真实浏览器,速度和资源占用都不是最优。项目的商业化方式也直白:开源版长期免费维护,断点续爬、多账号等进阶能力放在付费的 MediaCrawlerPro 里,README 里还有代理服务、数据 API 等赞助商广告位。
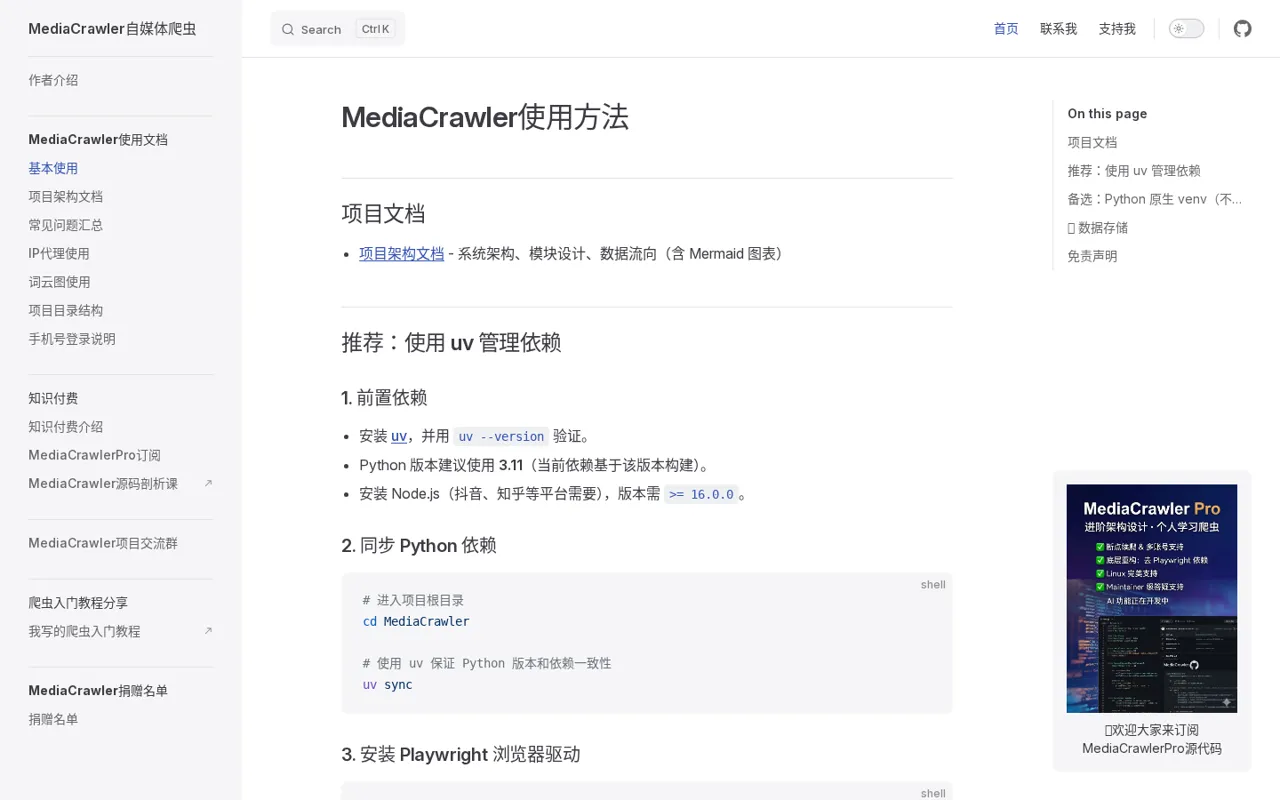
图:MediaCrawler 的官方文档站,含各平台使用说明与数据存储指南入口(2026-11 截图)
核心服务与功能
七个平台的功能矩阵是齐的:关键词搜索、指定帖子 ID 采集、二级评论、指定创作者主页、登录态缓存、IP 代理池、评论词云图生成,七项在七个平台上全部支持。采集结果可以存成 CSV、JSON、JSONL、Excel,或写入 SQLite、MySQL,仓库里有一份单独的数据存储指南。
登录方式有两种运行模式。默认的 CDP 模式连接你电脑上已有的 Chrome(要求版本 144 以上,在设置里开启远程调试),直接复用浏览器里现成的登录状态,省去反复扫码;另一种是标准 Playwright 模式,扫碼登录后缓存登录态下次复用。采集时可选是否开启评论抓取(配置文件里有单独开关),媒体下载是独立的可选项:开启后会把帖子的封面、视频、图文图片按帖子分文件夹下载,小红书和抖音的实况照片也能一并取下;B 站装好 ffmpeg 后可取 1080p 的 DASH 分轨合成,没装则自动降级为直链 mp4。
仓库还自带一个 WebUI:后端是本地 API 服务,前端构建后由同一个服务提供页面,能可视化填平台、登录方式、采集类型,实时看运行日志,并预览和导出数据。不想碰命令行的人可以用这个入口,但它仍然是跑在本机的开发式部署,不是开箱即用的成品软件。
不在开源版里的能力要说清:断点续爬、多账号加代理池调度、去掉 Playwright 依赖、评论分析与内容拆解等 AI Agent,属于付费的 MediaCrawlerPro,仓库 README 里明确列为 Pro 的差异点。站内旧稿把 Pro 的能力写成主项目功能,是不准确的。
使用方式
环境准备:先装 uv(作者推荐的 Python 包管理工具)和 Node.js 16 以上;克隆仓库后用 uv sync 一次装齐指定版本的 Python 与依赖。用默认 CDP 模式不需要装浏览器驱动,但要先把 Chrome 升到 144 以上并开启远程调试,程序启动时会弹出确认框,60 秒内点接受;只有切到标准 Playwright 模式时才需要额外安装其浏览器驱动。运行就是一条命令:指定平台(如 xhs)、登录方式(如 qrcode 扫码)和采集类型(search 按关键词、detail 按指定帖子),关键词等参数在 config/base_config.py 里改,文件里有中文注释。采集结果默认落在 data 目录,或按配置写进数据库。整个过程使用的是你自己的平台账号,采集频率与账号安全的关系见下一节的注意事项。
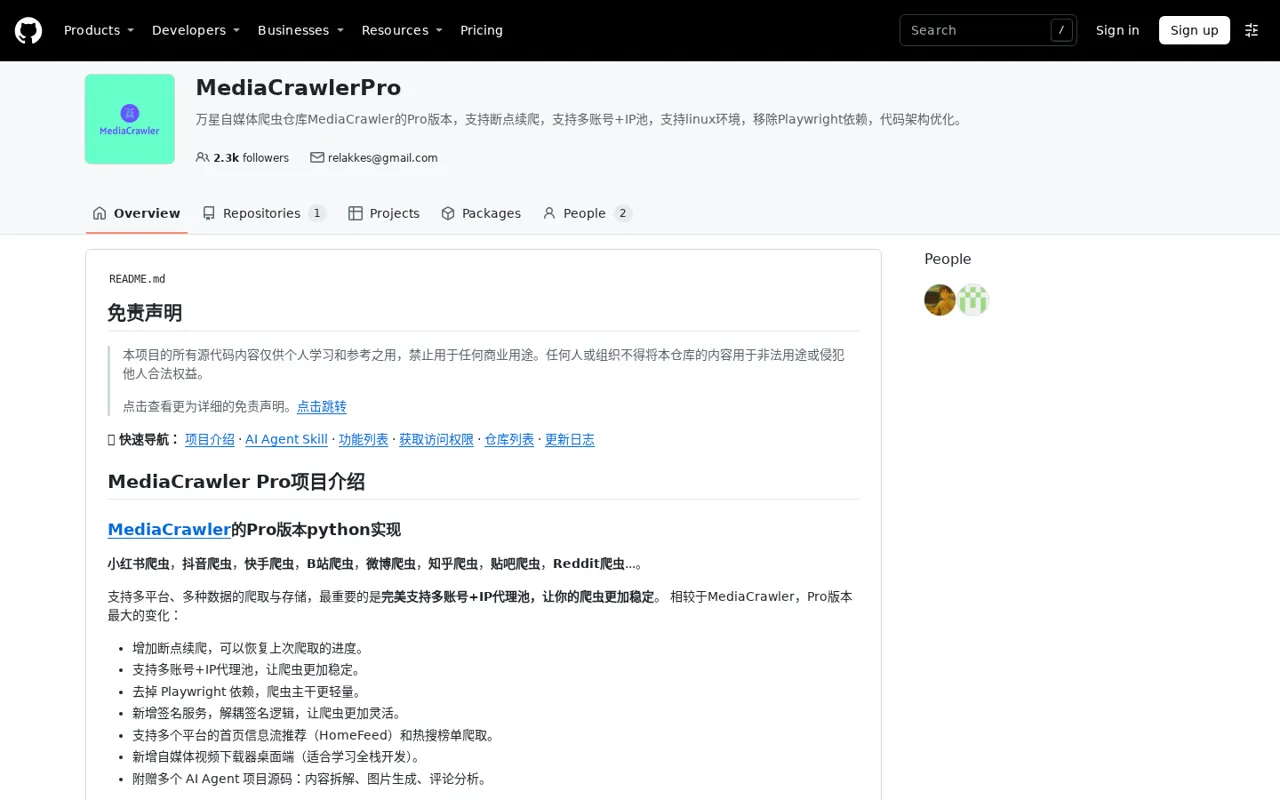
图:MediaCrawlerPro 的 GitHub 组织页,开源版之外的付费版本提供断点续爬、多账号与 AI Agent 等能力(2026-11 截图)
适用人群
- 做内容与舆情研究的人:围绕关键词或指定创作者,系统地留存公开帖子与评论做样本分析;
- 自媒体运营者:复盘自己账号与对标账号的已发布内容、评论反馈,做选题与复盘参考;
- 学爬虫与浏览器自动化的开发者:这个仓库的工程结构(多平台抽象、登录态管理、存储分层)本身就是一份可读的教材;
- 做学术研究、需要社交平台公开数据样本的学生与研究者。
它不适合的场景:需要大规模、长期、商业化采集的业务——这正是它的许可证和平台规则双重不允许的范围,需要这类能力的应走平台官方数据服务或持牌数据商。
免费与付费
| 版本 | 口径(2026-11 快照) |
|---|---|
| 开源版(GitHub 主仓库) | 免费;七平台采集、评论、媒体下载、词云、WebUI、多种存储格式齐全;许可证限定非商业学习用途 |
| MediaCrawlerPro | 付费订阅(官方未公开标价,以其项目主页为准);多出断点续爬、多账号 + IP 代理池、免 Playwright、评论分析与内容拆解 Agent、视频下载器桌面端等 |
| 隐性成本 | 自备电脑与运行环境;如使用代理 IP、短信等第三方服务,费用另付(仓库赞助页有代理商广告,自行甄别) |
优缺点
优点:
- 平台覆盖与功能矩阵在同类开源项目里最全,七个平台四种采集方式加二级评论全部打通;
- 免逆向的技术路线对使用者友好,登录态复用加 CDP 模式把上手门槛压到了「会装 Python 环境」的程度;
- 维护活跃、文档成体系(存储指南、WebUI 说明、各平台配置注释都是中文);
- 开源版与付费版的边界在 README 里写得明明白白,没有暗藏阉割。
缺点:
- 许可证是非商业学习许可,不是 MIT / Apache 那类宽松开源协议,商用场景直接出局;
- 靠浏览器自动化运行,速度慢、吃资源,平台页面或规则一变就可能失效,要跟随作者更新;
- 断点续爬、多账号调度这些长任务真正需要的功能只在付费版;
- 使用效果与风险都绑定在你自己的平台账号上,没有「与我无关」的用法。
同类竞品对比
| 工具 | 形态 | 侧重 | 费用 |
|---|---|---|---|
| MediaCrawler(本文) | 开源采集工具 | 七平台帖子与评论采集,本地运行、数据落自己的库,非商业学习定位 | 开源版免费;Pro 版订阅、价格未公开 |
| social-auto-upload | 开源自动化工具 | 方向相反:它解决的是把内容批量发布到各平台,是「发」的工具,MediaCrawler 是「取」的工具,常在同一条运营流水线里前后接力 | 免费开源 |
| DrissionPage | 浏览器自动化库 | 更底层的网页自动化框架,适合自己写采集逻辑;MediaCrawler 是基于同类技术做好的成品方案,省了开发但少了灵活 | 免费开源 |
注意事项与风险
- 平台规则:小红书、抖音、B 站等平台的用户协议普遍禁止未经授权的自动化抓取、批量采集和绕过访问限制的行为;用自己的账号跑这类工具,账号被限流、封禁乃至追究责任的风险由使用者自担,与工具是否开源无关;
- robots 与访问边界:对设有 robots.txt 限制或明确反爬声明的页面,应尊重其规则;只采集公开展示的信息,不碰需要越权、破限才能拿到的非公开数据;
- 个人信息合规:评论区里含有大量真实用户的昵称、头像与言论,按《个人信息保护法》,采集后的存储、使用、分享都要有合法依据,尤其不得把含个人信息的数据对外出售、公开传播或用于营销骚扰,学术研究也应做去标识化处理;
- 许可证边界:本项目采用非商业学习许可,作者在许可证与免责声明中写明禁止商业用途、禁止大规模爬取与干扰平台运行,把它接进商业产品或对外提供采集服务不在授权范围内;
- 量力而行:控制采集范围与频率,只取研究真正需要的样本;平台风控与规则会变,本文的功能与口径为 2026-11 快照,重要用途前再看一眼仓库的最新说明与免责声明。
相关软件
Bolt.diy:自部署AI开发工具 - 最新版
Bolt.diy 是 Bolt.new 的开源自部署版本,在浏览器内用自然语言生成、运行并部署全栈 Web 应用,可自由接入 22+ 家云端模型与本地模型,MIT 协议免费,软件零费用、成本只在模型 API 账单。
NarratoAI:AI剪辑解说视频工具 - 最新版
NarratoAI 是开源 AI 影视解说与自动剪辑工具:大模型写解说文案、自动剪辑、配音与字幕一条龙,支持短剧解说与混剪,仓库约 1.18 万 Star 且仍在活跃更新。
暂无评论...