
Gemini Notebook(原 NotebookLM):AI 研究与笔记工具
NotebookLM深度评测:现名Gemini Notebook,来源约束问答与音频概览,免费层100笔记本×50来源与Plus/Pro额度解析。
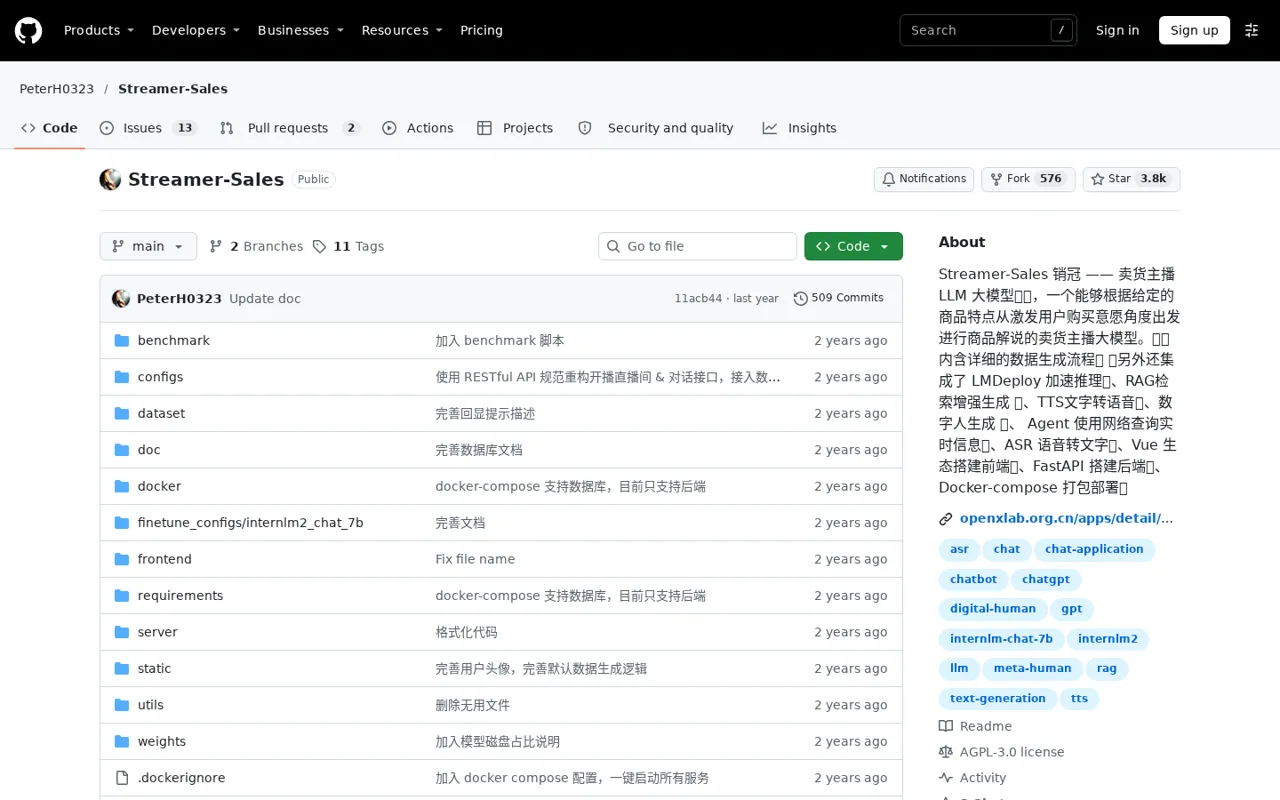
图:Streamer-Sales 仓库首页,展示卖货主播大模型的定位与功能构成(2026-11 截图)
Streamer-Sales(销冠)是一个开源的「卖货主播大模型」项目,代码托管在 GitHub 仓库 PeterH0323/Streamer-Sales。它的核心是一个用 XTuner 在 InternLM2 上指令微调出的带货解说模型 lelemiao-7b:给定商品特点,生成从激发购买意愿出发的商品解说文案;仓库同时把推理、语音、数字人、前后端与部署整合成一套可以完整跑起来的直播带货系统,而不只是一个模型权重。项目采用 AGPL-3.0 许可证。截至 2026 年 11 月快照,仓库约 3,800 Star、570+ Fork、15 个未关闭 Issue,创建于 2024 年 4 月;版本标签发到 v0.10.0,但仓库最近一次推送停在 2025 年 3 月,更新节奏明显放缓(详见背景与缺点部分)。模型权重托管在 ModelScope 与 OpenXLab,另有 OpenXLab 在线 Demo。
这个项目诞生在 2024 年大模型应用竞赛与开源微调最热的阶段,思路是把「主播」拆解成可工程化的链路:文案由微调模型生成,说明书更新靠 RAG 检索增强,声音靠带感情的 TTS,说话的人靠数字人生成,查快递等实时信息靠 Agent 联网,观众语音靠 ASR 转文字,再由 LMDeploy 做推理加速。训练侧用约 40 万 Token 的带货语料在 internlm2-chat-7b 上微调(仓库原文口径),并提供全参版本与 4bit 量化版本两个权重。它的价值定位一直是教学与二次开发样例:把「垂直领域微调 + 多模块编排」的完整工程摊开给开发者看。也要如实指出,仓库 NEWS 主要集中在 2024 年(接入 PostgreSQL、RESTful 重构等),2025 年 3 月之后没有新的推送,基座模型 InternLM2 也已不是当前主流选型,如今部署它应按「成熟样例」而非「持续演进的产品」来预期。
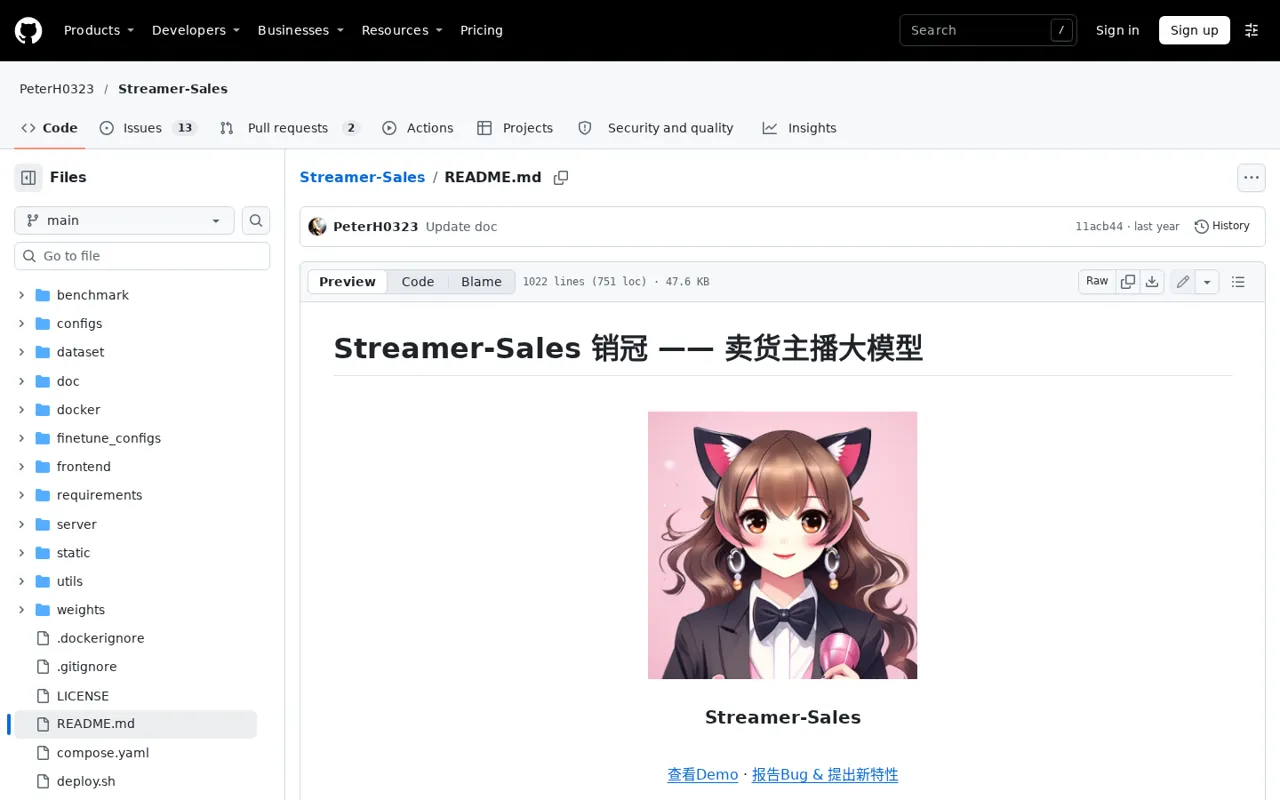
图:Streamer-Sales 仓库 README 文档页,含模型说明、部署与显存配置(2026-11 截图)
最轻量的体验是打开 OpenXLab 上的在线 Demo,先看模型生成的解说文案长什么样。本地部署则按 README 走:克隆仓库,从 ModelScope 下载 lelemiao-7b 权重,显存 40G 左右的机器跑全参版,24G 显卡改用 4bit 量化版,再用 Docker-compose 拉起前后端与数据库。想换成自己的商品,需要按仓库给的数据生成流程准备语料,用 XTuner 重新微调——这一步对 GPU 与耐心都有要求。部署完成后在前端输入商品信息,即可得到文案、语音与数字人视频的整条链路输出。全程不需要向任何平台付费,但电费与显卡是真实成本。
实际体验链路可以拆成四段:先在前端填商品卖点,模型写出解说文案;文案进 RAG 校验与说明书对齐,避免把参数说错;接着 TTS 合成带货语调的语音,数字人模块按语音生成出镜视频;直播场景下观众的语音提问经 ASR 转成文字,再回到模型生成回应。仓库把这四段的接口都留了出来,二次开发时替换其中一段——比如换一个更好的 TTS 或数字人服务——不必动其余部分,这也是它至今仍被当作底座参考的原因。
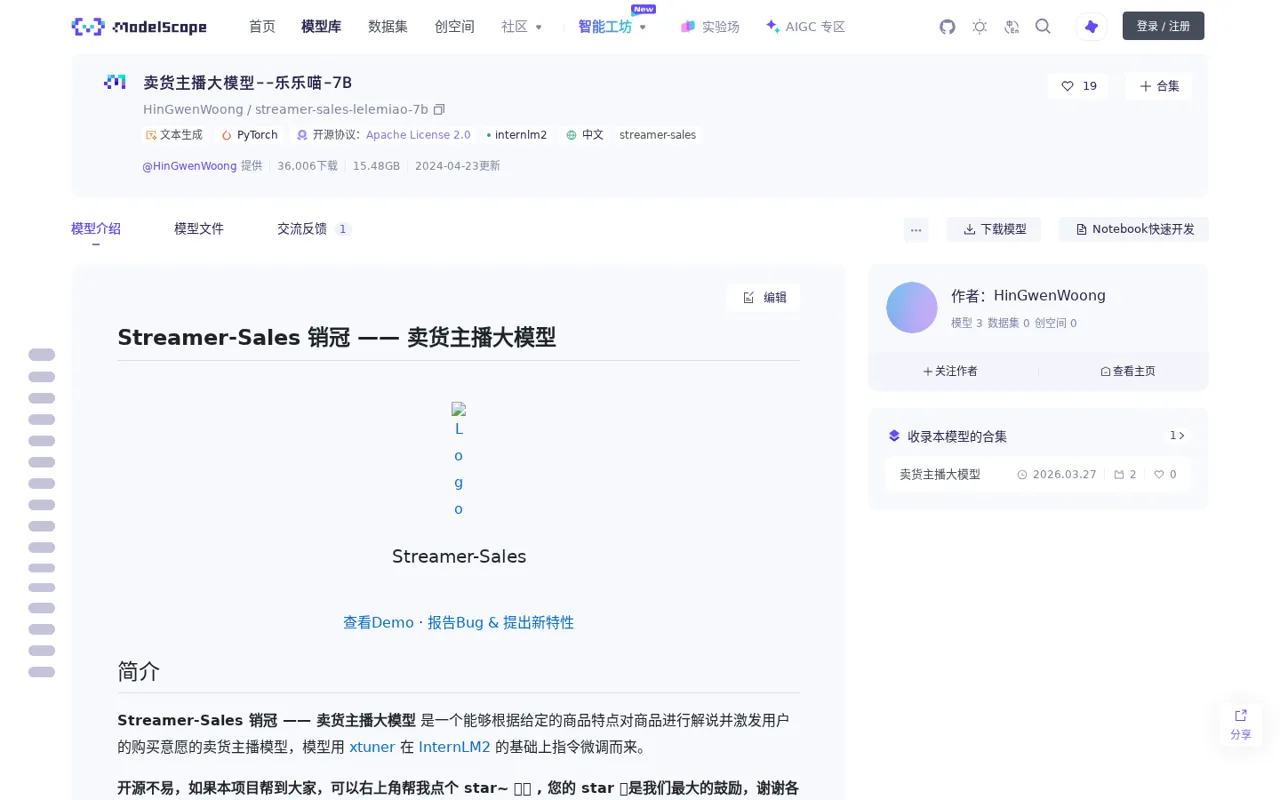
图:lelemiao-7b 模型在 ModelScope 的模型页,可下载全参权重(2026-11 截图)
适合想学习垂直领域大模型微调全流程的开发者与学生:数据生成、训练、量化、推理加速、RAG、语音与数字人编排、工程化部署,它把一整套都摊开了。也适合做直播电商工具的产品团队拿它当原型底座验证想法。不适合的人群:想开箱即用地做真人级直播带货的商家——数字人效果、话术质量与平台规则都不允许把它当成无人直播的捷径;没有 GPU 资源又不想用云算力的用户,本地部署门槛会直接劝退。
项目本身开源免费,没有官方订阅或授权费(2026-11 快照);但 AGPL-3.0 是强 copyleft 许可证,基于它修改并对外提供网络服务时有开源义务,商用前应先让法务确认。真实成本在算力:自备显卡、电费,或租用云 GPU 的费用。模型权重在 ModelScope 免费下载。下表为成本结构说明:
| 项目 | 成本 | 说明 |
|---|---|---|
| 代码与权重 | 0 元 | GitHub 与 ModelScope 免费获取,AGPL-3.0 |
| 在线 Demo | 0 元 | OpenXLab 托管体验,额度以平台为准 |
| 本地部署 | 自备硬件 | 全参建议 40G 显存,4bit 版 24G 显卡可跑 |
| 再微调 | 自备算力 | 语料生成与训练的 GPU 时间由使用者承担 |
优点
缺点
| 维度 | Streamer-Sales 销冠 | MoneyPrinter V2 | NarratoAI |
|---|---|---|---|
| 定位 | 卖货主播大模型与直播系统 | AI 自动化短视频生成 | AI 剪辑解说视频工具 |
| 核心产出 | 带货文案、语音与数字人直播流 | 成片的短视频 | 带解说的剪辑成片 |
| 形态 | 自带微调模型,需 GPU 部署 | 本地运行的生成流水线 | 本地运行的剪辑流水线 |
| 收费 | 开源免费(AGPL-3.0) | 以其页面为准 | 以其页面为准 |
| 中文支持 | 中文语料微调,中文优先 | 中文为主 | 中文为主 |
三者处在 AI 视频链条的不同位置:销冠解决「谁来卖、说什么」,偏直播与实时互动;MoneyPrinter V2 与 NarratoAI 解决「批量产出可发布的短视频与解说片」,偏离线生产。若目标是做带货直播的数字人原型,销冠是这一组里唯一把微调模型本体都开源出来的。