
dots.ai:小红书自研大模型的 API 开放平台(限时免费)
dots.ai 是小红书的大模型 API 平台,主推自研模型 dots3-note preview(280B MoE、512K 上下文、多模态),权重 Apache-2.0 开源,API 为限时免费口径。
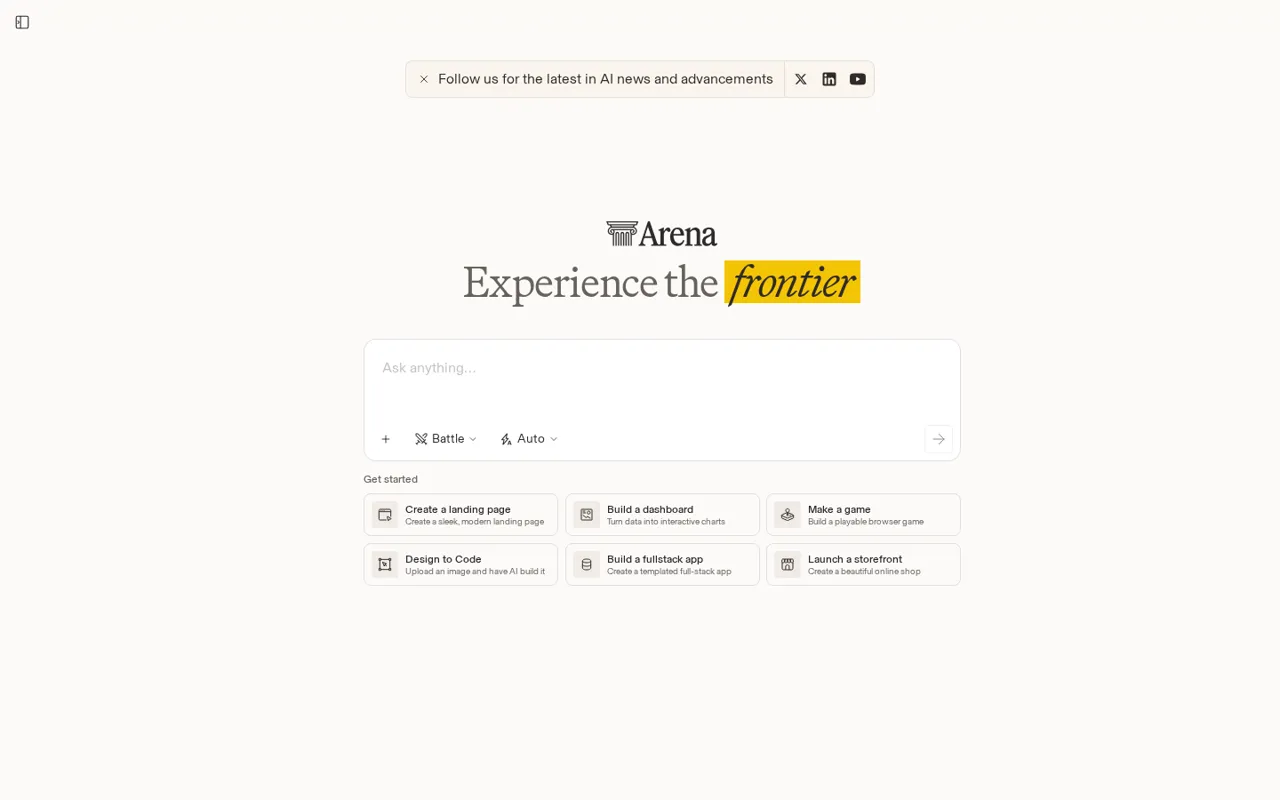
图:Arena(原 LMArena)官网首页,标题为「Arena AI:官方 AI 排名与 LLM 排行榜」,提供匿名双模型对战入口(2026-11 截图)
先说清名称:这个站就是原来的 LMArena,2026 年 1 月 28 日起改名为 Arena,官网迁到 arena.ai,老域名 lmarena.ai 自动跳转过去。再往前追,它的前身是 2023 年加州大学伯克利分校 LMSYS 团队做的 Chatbot Arena。它干的事只有一件,但做成了行业标尺:让两个匿名大模型回答同一个问题,用户盲选更好的一个,票数经 Bradley–Terry 模型换算成分数,汇成公开排行榜。站内条目还挂在 LMArena 名下,本条目按改名后的现状重写。截至 2026 年 11 月,它仍是免费使用:对战和投票不需要注册,全部榜单公开可查,没有面向个人的付费版——凡是要收费看榜的「LMArena」都是仿冒站。
时间线有三段。2023 年 5 月 3 日,Chatbot Arena 作为伯克利的研究项目上线,思路是绕开各家自报的跑分,用真实用户的盲测投票排座次,上线后迅速成为大模型发布时必引的第三方榜单。2024 年 9 月,站点迁到独立域名 lmarena.ai,LMArena 这个名字叫开。2025 年 4 月,团队注册 Arena Intelligence 公司独立运营;2026 年 1 月 28 日正式改名 Arena 并启用 arena.ai。公司化之后它的商业面浮出水面:按公开报道(彭博社等),平台 2026 年 10 月完成 2 亿美元 B 轮融资、估值 31 亿美元,公司口径的月访问量在数千万级,累计投票 8,200 万、对话 7 亿次——这些数字说明它已不只是学术项目,而是模型厂商发布新品时做第三方评测的基础设施,厂商付费评测与数据服务是其收入方向,个人用户的免费对战则是它获取投票数据的入口。
图:Hugging Face 上的 Arena 官方排行榜页,汇总各分类榜单与分数(2026-11 截图)
核心玩法是 Battle(对战):输入一个问题,左右两个匿名模型同时作答,读完选一边更好,或选平局、双差,投票后才揭晓两边是谁。持续投票的数据汇成 Leaderboard(排行榜):文本榜是旗舰,另有代码与 WebDev、视觉理解、文生图、图像编辑、搜索、文生视频、图生视频、文档等分类榜,每条目带分数和置信区间,支持按类别、场景细分筛选(如文本榜下可按编程、数学、创意写作等子项看)。2026 年 10 月底的一次公开快照能说明它的量级:文本榜共 9,003,272 张票、419 个模型配置,榜首是谷歌 Gemini 4 Carbon (High),1,540 分,且被标注为 Preliminary(初步,票数尚少)。分数之外,官网还有 About 页交代方法与历史,页面导航里有排行榜变更日志(Changelog)和按性价比排的 Pareto 前沿视图,把「每单位成本换多少分」也做成了榜。历史榜单在 Hugging Face 上有官方 Space 镜像,查旧数据方便。
两种用法。想选模型,先看榜:打开 arena.ai 的排行榜,按自己关心的分类和子场景筛,比如写代码就看 WebDev/代码榜,做图就看文生图榜,注意同时看置信区间——两个模型分差小于区间宽度时,排名先后基本是噪声。想亲手验,进对战:把你真实工作中的问题原样贴进去,两个模型盲答,凭输出质量投票,多打几轮,揭晓身份后看胜出的常客是谁,这比看总榜更贴合个人场景。全程不用注册,但要知道:你输入的问题和投票会被用作研究与榜单数据,不要贴公司代码、合同、个人信息等敏感内容。对战里遇到未发布的新模型是常事,揭晓时标注 Preliminary 的,分数还会大幅波动,别急着下结论。
补充一个容易忽略的机制细节:只有在双方身份未揭晓时投出的票才计入排名,投票后揭晓身份正是防刷的关键设计;每个条目同时给出 95% 置信区间,票数越少的模型区间越宽。官方在 2024 年的研究中发现回答长度、格式(标题、加粗、列表)会系统性影响得票,因此榜单现在默认开启风格控制(Style Control),把这部分偏好剥离后再排名——你在榜单页看到的默认名次已经是修正后的结果,关掉风格控制看到的又是另一套顺序,引用名次时要注明是哪种口径。
适合:要在几个大模型之间做选型的个人与团队,尤其是订阅前想横向比较的;跟踪模型版本迭代的从业者和媒体,榜单变化是最快的行业风向之一;做模型评测、研究人类偏好的研究者。不适合:把榜单名次直接当采购结论的人——它测的是「用户更喜欢哪个回答」,不是正确率、事实性和专业任务的完成度;需要私有化、数据不出内网的企业场景,这里是公开对战平台;以及只用中文工作、对中文语境表现敏感的用户,投票人群的语种构成会影响排序,中文能力要自己用对战验。
图:Arena 官网 About 页,交代其由伯克利研究团队起家及 Chatbot Arena 到 Arena 的沿革(2026-11 截图)
截至 2026 年 11 月,Arena 对个人用户免费:对战、投票、查榜都不收费,也不需要注册账号。它明确不存在「付费解锁完整榜单」这种个人订阅,凡是打着 LMArena/Arena 旗号收费看榜、收费投票的网站都不是官方。其收入来自面向模型厂商的评测与数据服务一侧,具体合作口径以官网为准,与普通用户无关。对用户真正的「成本」不是钱,而是数据:你贡献的问题与投票会进入其数据集,介意者只看榜、不对战,或不对敏感问题投票。
优点:
缺点:
| 条目 | 形态 | 核心问题 | 数据/机制 | 费用 |
|---|---|---|---|---|
| Arena(本条,原 LMArena) | 盲测对战 + 排行榜 | 哪个模型用户更喜欢 | 真实用户投票,Bradley–Terry 计分 | 免费 |
| Perplexity | AI 搜索产品 | 直接给带出处的答案 | 检索加模型生成,不是评测平台 | 免费版 + 付费版 |
| ModelScope | 模型社区与托管平台 | 找模型、下载、部署 | 模型仓库与在线体验,非盲测排名 | 免费为主 |
三者不在一个赛道:Arena 回答「哪个模型更强」,Perplexity 是拿来干活的搜索工具,ModelScope 是拿模型和算力的仓库。选型时用 Arena 缩小范围,再去 ModelScope 或各家官网实测。
第一,防仿冒:官方域名只有 arena.ai(及跳转过来的 lmarena.ai),搜索结果里带「付费看榜」「充值投票」的同名站全是假的,不要在上面输入账号密码或付款。第二,隐私:对战输入会被用作研究数据并可能公开,严禁贴未公开代码、客户资料、个人身份信息。第三,读榜的方法:分差小于置信区间就是没分出胜负;带 Preliminary 的新模型先等票数攒够;文本总榜的名次不能替代编程、中文写作等子场景榜。第四,把争议当背景了解即可:偏好型榜单天然偏向「讨喜」的回答,专业任务(法律、医疗、财务)的实际可用性,必须用自己的真实样本复测,榜单名次不构成任何场景的选用保证。第五,名称过渡期引用易错:2026 年以前的文章、书签里写的 LMArena、Chatbot Arena 与现在的 Arena 是同一平台,查资料时三个名字都要搜。